Meta présente Muse Wonder et Muse Wonder Full, deux modèles pensés pour les agents personnels et professionnels. Benchmarks publiés, prix de l’API, accès via Muse Code et limites face à Claude Opus 5.5.
Meta a présenté le 12 octobre 2026 la série Muse Wonder, composée de deux modèles : Muse Wonder et Muse Wonder Full. Meta les décrit comme ses modèles les plus performants à ce jour et les premiers à atteindre la frontière des modèles de pointe, avec un objectif clair : faire fonctionner des agents personnels et professionnels. Muse Wonder est disponible immédiatement dans le Meta Model API et dans Muse Code, au prix de 4 $ par million de jetons en entrée et 20 $ en sortie. Muse Wonder Full est réservé aux abonnés Muse Code des forfaits Power Usage et Maximum Usage.
En un coup d’œil
| Point | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Date d’annonce | 12 octobre 2026 | 12 octobre 2026 |
| Accès | Meta Model API et Muse Code | Muse Code uniquement, sur abonnement |
| Prix | 4 $ en entrée, 0,20 $ en entrée mise en cache, 20 $ en sortie, par million de jetons | Inclus dans les forfaits Power Usage (50 $ par mois) et Maximum Usage (200 $ par mois) |
| Fenêtre de contexte | 1 million de jetons | 1 million de jetons |
| Identifiant API | muse-wonder-1.0 | Non proposé dans l’API |
| Artificial Analysis Intelligence Index | 52 | 56 |
Prix catalogue en dollars indiqués par Meta, hors taxes.
Qu’est-ce que Muse Wonder ?
Muse Wonder est une nouvelle famille de grands modèles de langage développée par Meta Superintelligence Labs. Elle succède à Muse Spark, la première famille de modèles du laboratoire. Mark Zuckerberg l’a résumé sur X : un peu plus d’un an après la création de Meta Superintelligence Labs, Muse Wonder est une classe de modèles beaucoup plus grande et plus avancée, qui amène Meta à la frontière. Son message de lancement a dépassé 3 400 mentions J’aime et 450 000 vues.
Selon Meta, la refonte de ses efforts en intelligence artificielle a commencé il y a quatorze mois, en reconstruisant toute la pile technique à partir des principes de base. Les deux modèles ont été entraînés dans Prometheus, le centre de données de Meta à l’échelle du gigawatt. Meta les présente comme une nouvelle étape vers ce que l’entreprise appelle la « superintelligence personnelle », destinée aux milliards de personnes qui utilisent ses produits.
La différence entre les deux versions est simple. Muse Wonder Full est le modèle le plus avancé, avec les meilleurs scores. Muse Wonder est la version proposée à tous les développeurs dans l’API, et Meta indique que ses performances sont comparables à celles de Muse Wonder Full.
Active Memory et Active Focus : les deux idées clés
Meta organise l’annonce autour de deux capacités qu’il juge indispensables pour un agent utile.
Active Memory désigne la mémoire active. Le modèle doit retenir le contexte important d’une conversation à l’autre et retrouver de lui-même les détails utiles pour la tâche en cours. Pour un agent personnel, cela signifie se souvenir des préférences, des contraintes et des décisions passées sans qu’il faille tout répéter.
Active Focus désigne la persévérance face à une tâche difficile. Le modèle essaie d’autres approches, contourne les blocages et s’adapte aux informations nouvelles. Meta précise qu’il demande des clarifications si besoin et vérifie avec l’utilisateur avant toute action importante.
La documentation pour développeurs ajoute d’autres capacités : raisonnement sur plusieurs étapes, exécution complète de tâches avec des outils, délégation à des sous-agents, reprise après une erreur d’outil et raisonnement multimodal sur des captures d’écran, des graphiques, des documents, des images et des vidéos. Meta note toutefois que les usages qui dépendent de l’audio doivent être vérifiés sur chaque surface de diffusion.
Que disent les benchmarks publiés par Meta ?
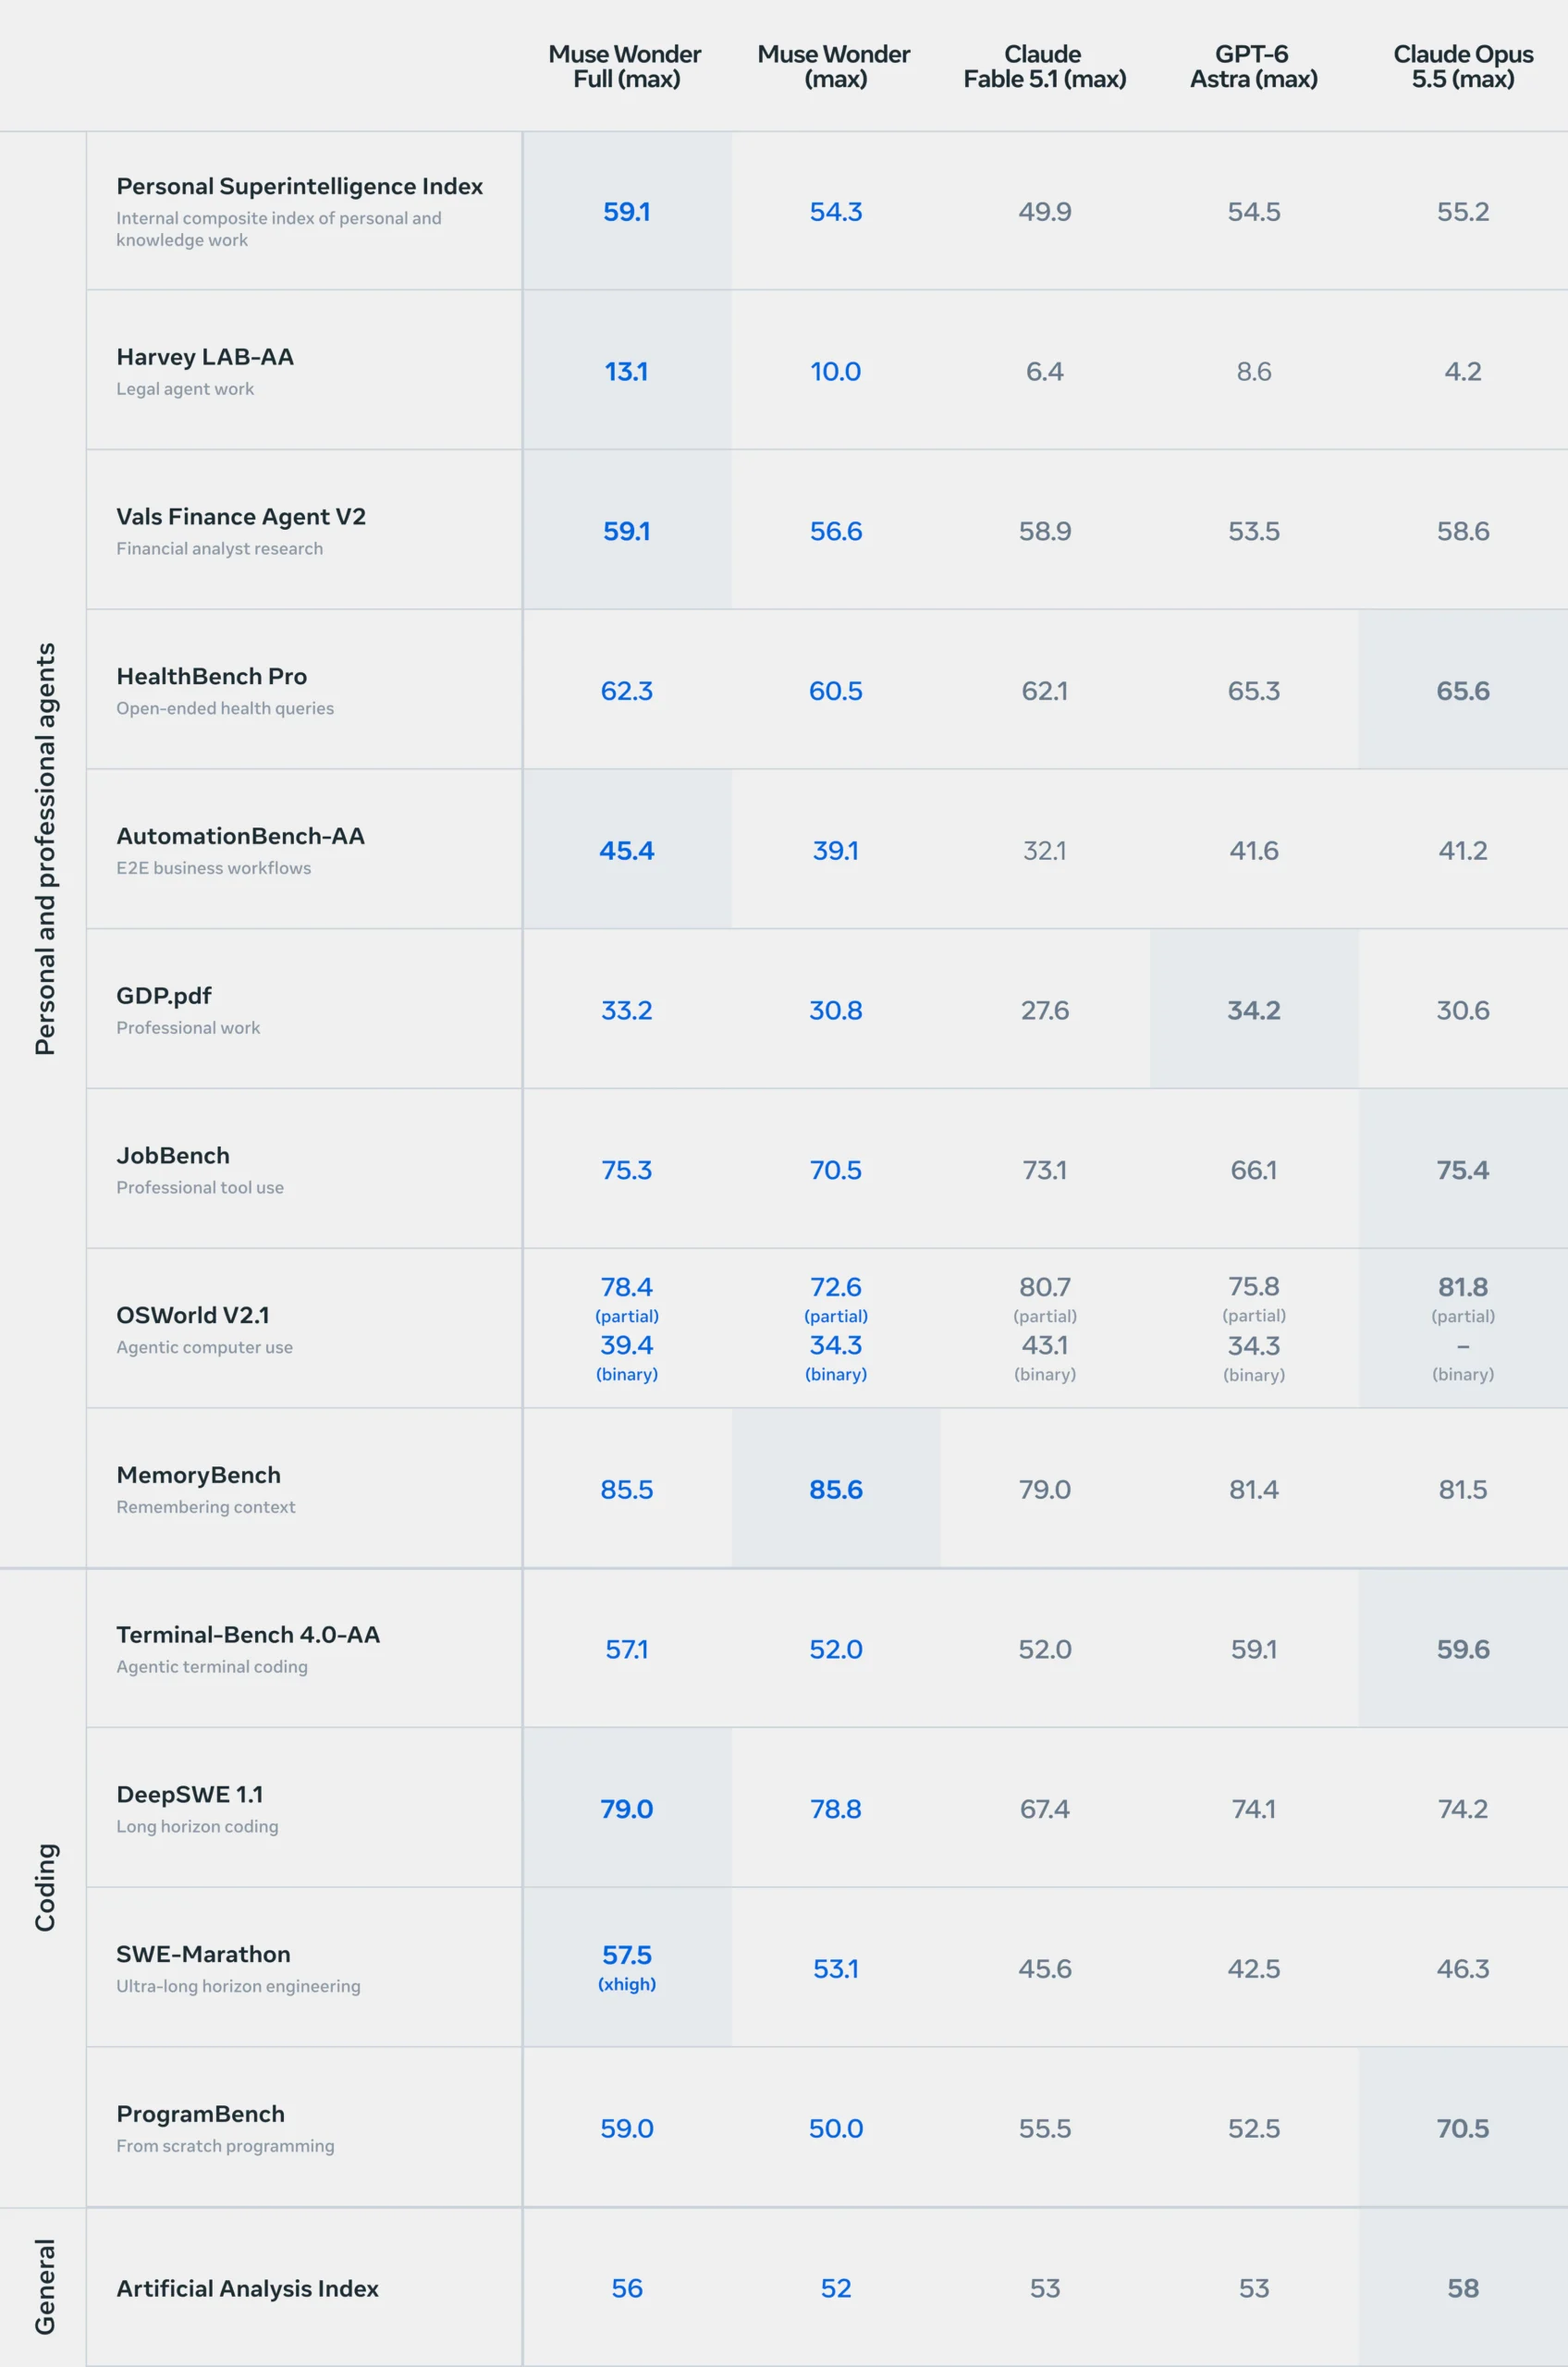
Meta compare ses deux modèles à Claude Fable 5.1, GPT-6 Astra et Claude Opus 5.5, tous réglés sur leur effort de raisonnement maximal. Selon le tableau officiel de Meta, ce sont les résultats annoncés par l’entreprise, pas des tests indépendants, sauf mention contraire.
Agents personnels et professionnels
- Personal Superintelligence Index, l’indice interne de Meta pour le travail personnel et intellectuel : 59,1 pour Muse Wonder Full et 54,3 pour Muse Wonder, contre 55,2 pour Claude Opus 5.5, 54,5 pour GPT-6 Astra et 49,9 pour Claude Fable 5.1.
- Harvey LAB-AA, consacré au travail juridique : 13,1 pour Muse Wonder Full, contre 8,6 pour GPT-6 Astra et 4,2 pour Claude Opus 5.5.
- AutomationBench-AA, sur des processus métier de bout en bout : 45,4 pour Muse Wonder Full, contre 41,6 pour GPT-6 Astra et 41,2 pour Claude Opus 5.5.
- Vals Finance Agent V2, sur la recherche d’analyste financier : 59,1 pour Muse Wonder Full, juste devant Claude Fable 5.1 (58,9) et Claude Opus 5.5 (58,6).
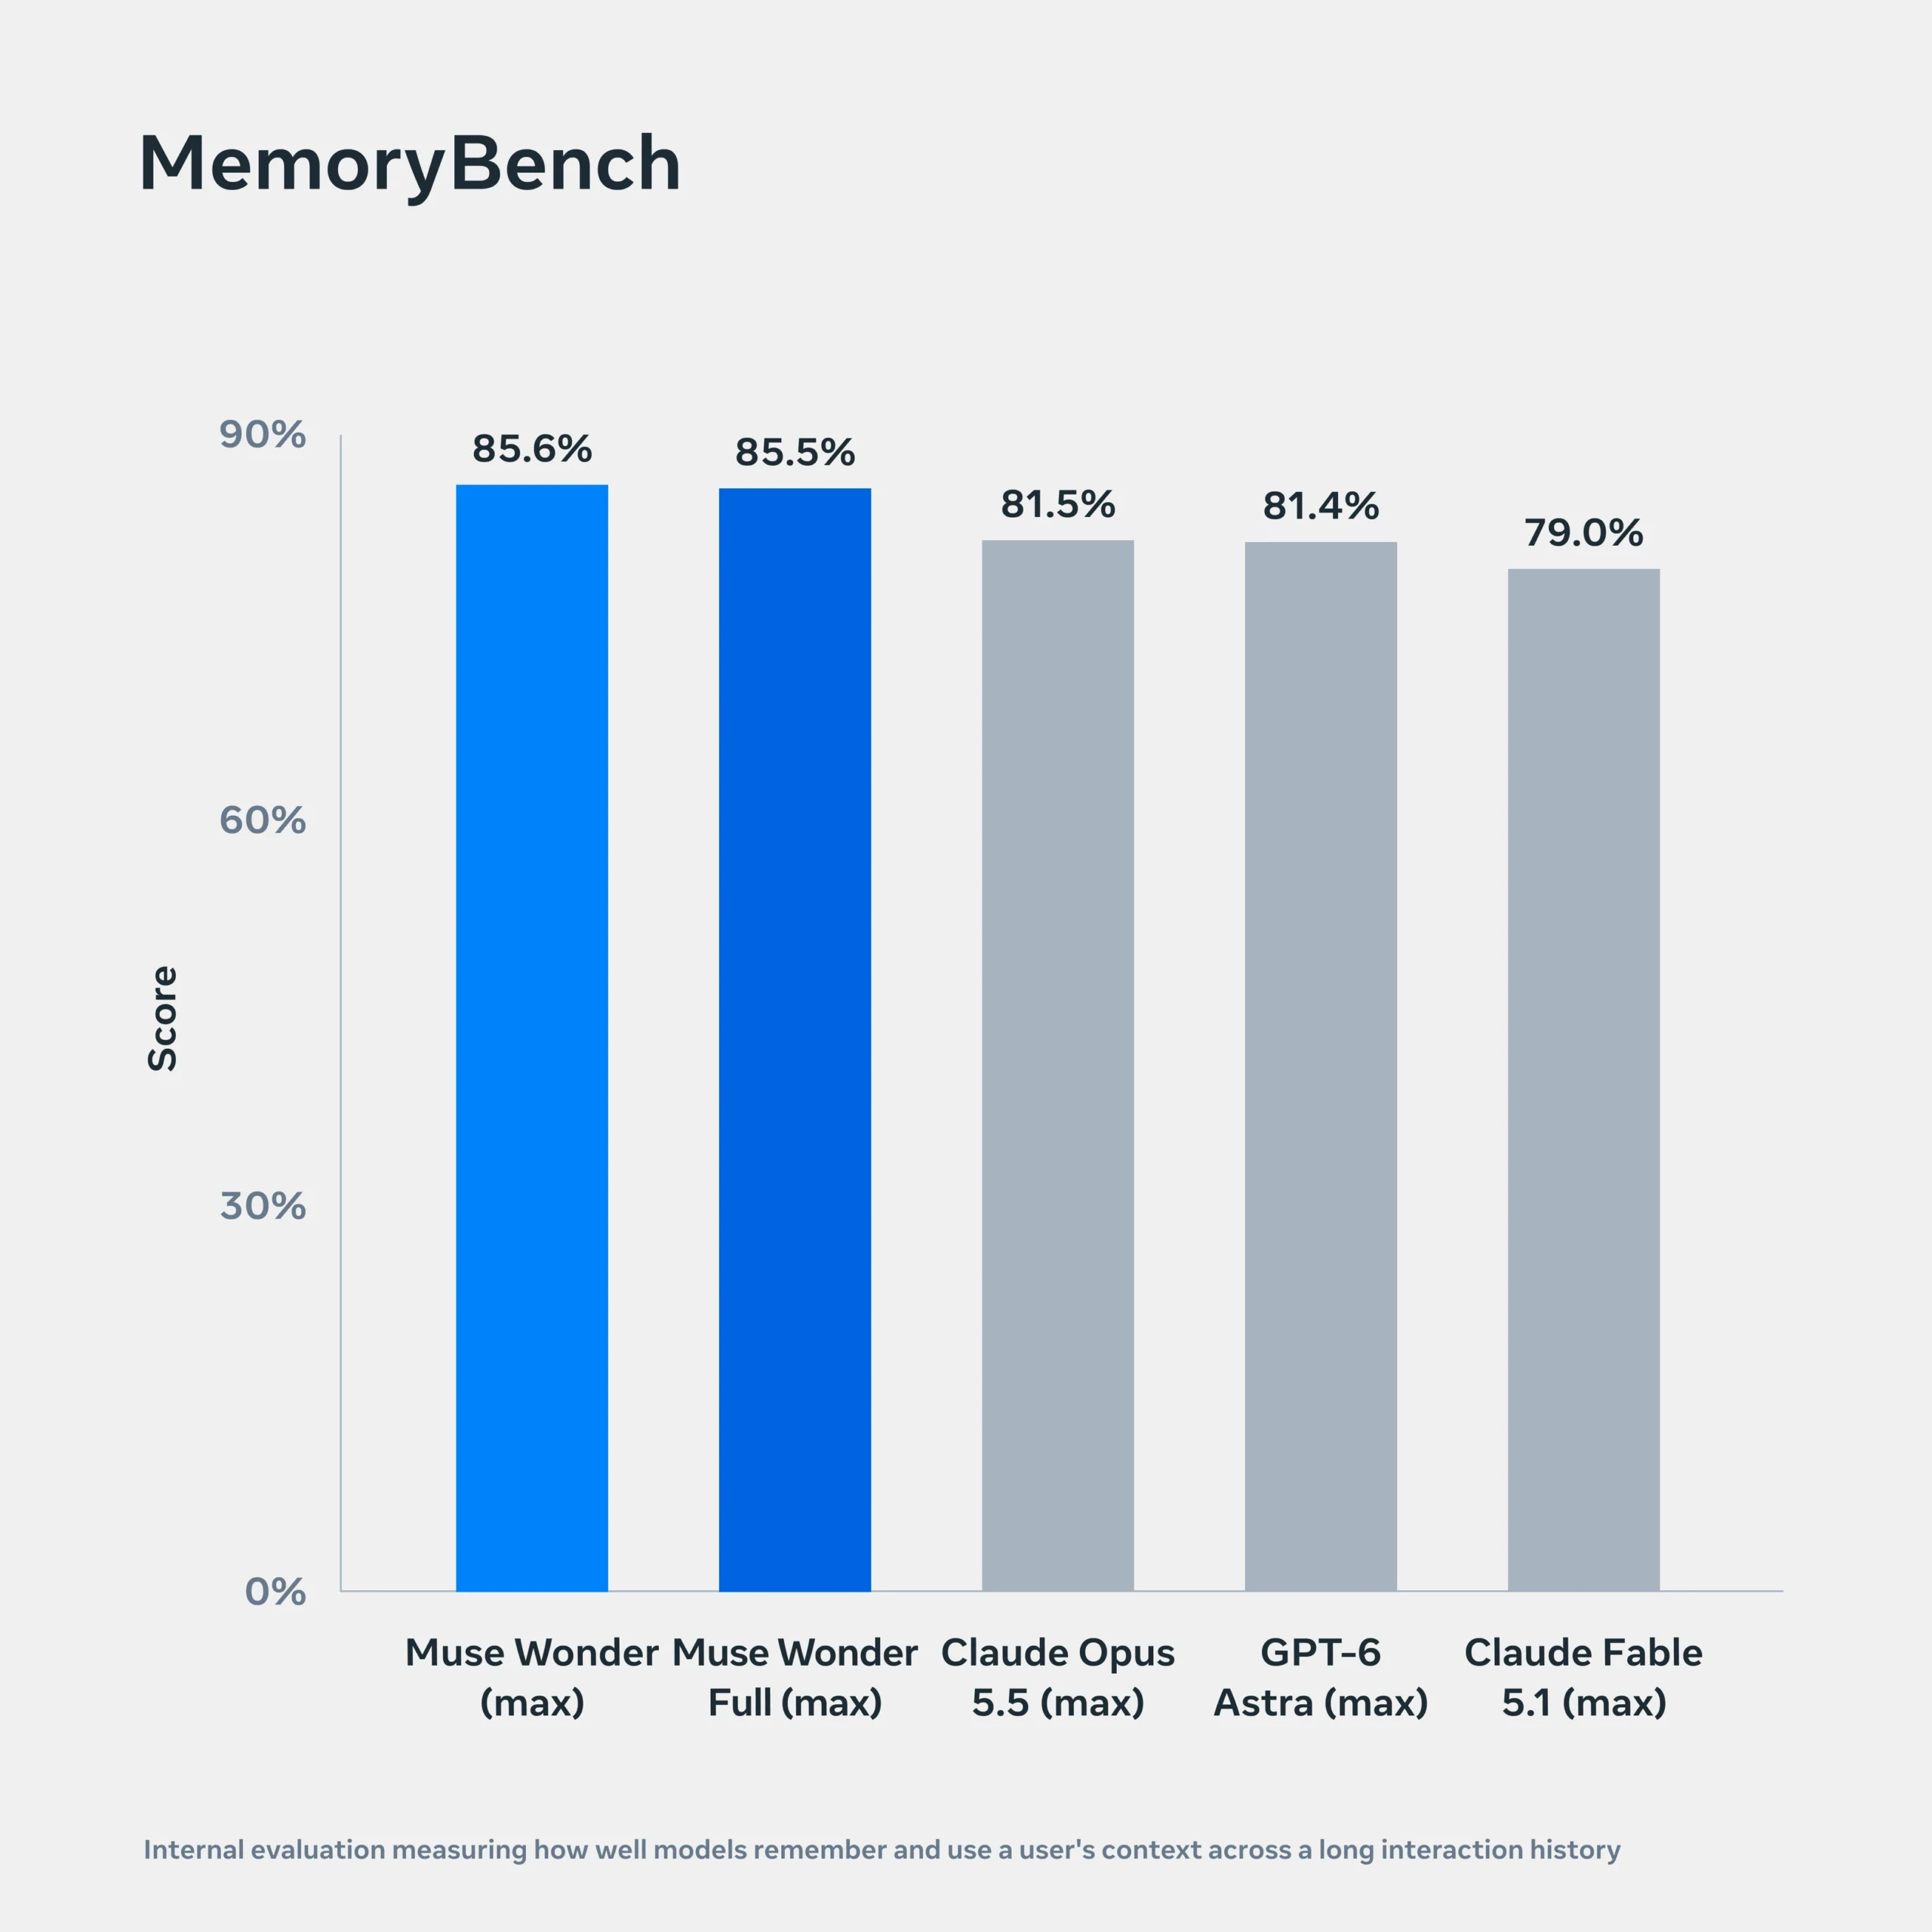
- MemoryBench, sur la mémoire du contexte : 85,6 pour Muse Wonder et 85,5 pour Muse Wonder Full, contre 81,5 pour Claude Opus 5.5.
Code
- DeepSWE 1.1, sur le code à long horizon : 79,0 pour Muse Wonder Full et 78,8 pour Muse Wonder, contre 74,2 pour Claude Opus 5.5 et 74,1 pour GPT-6 Astra.
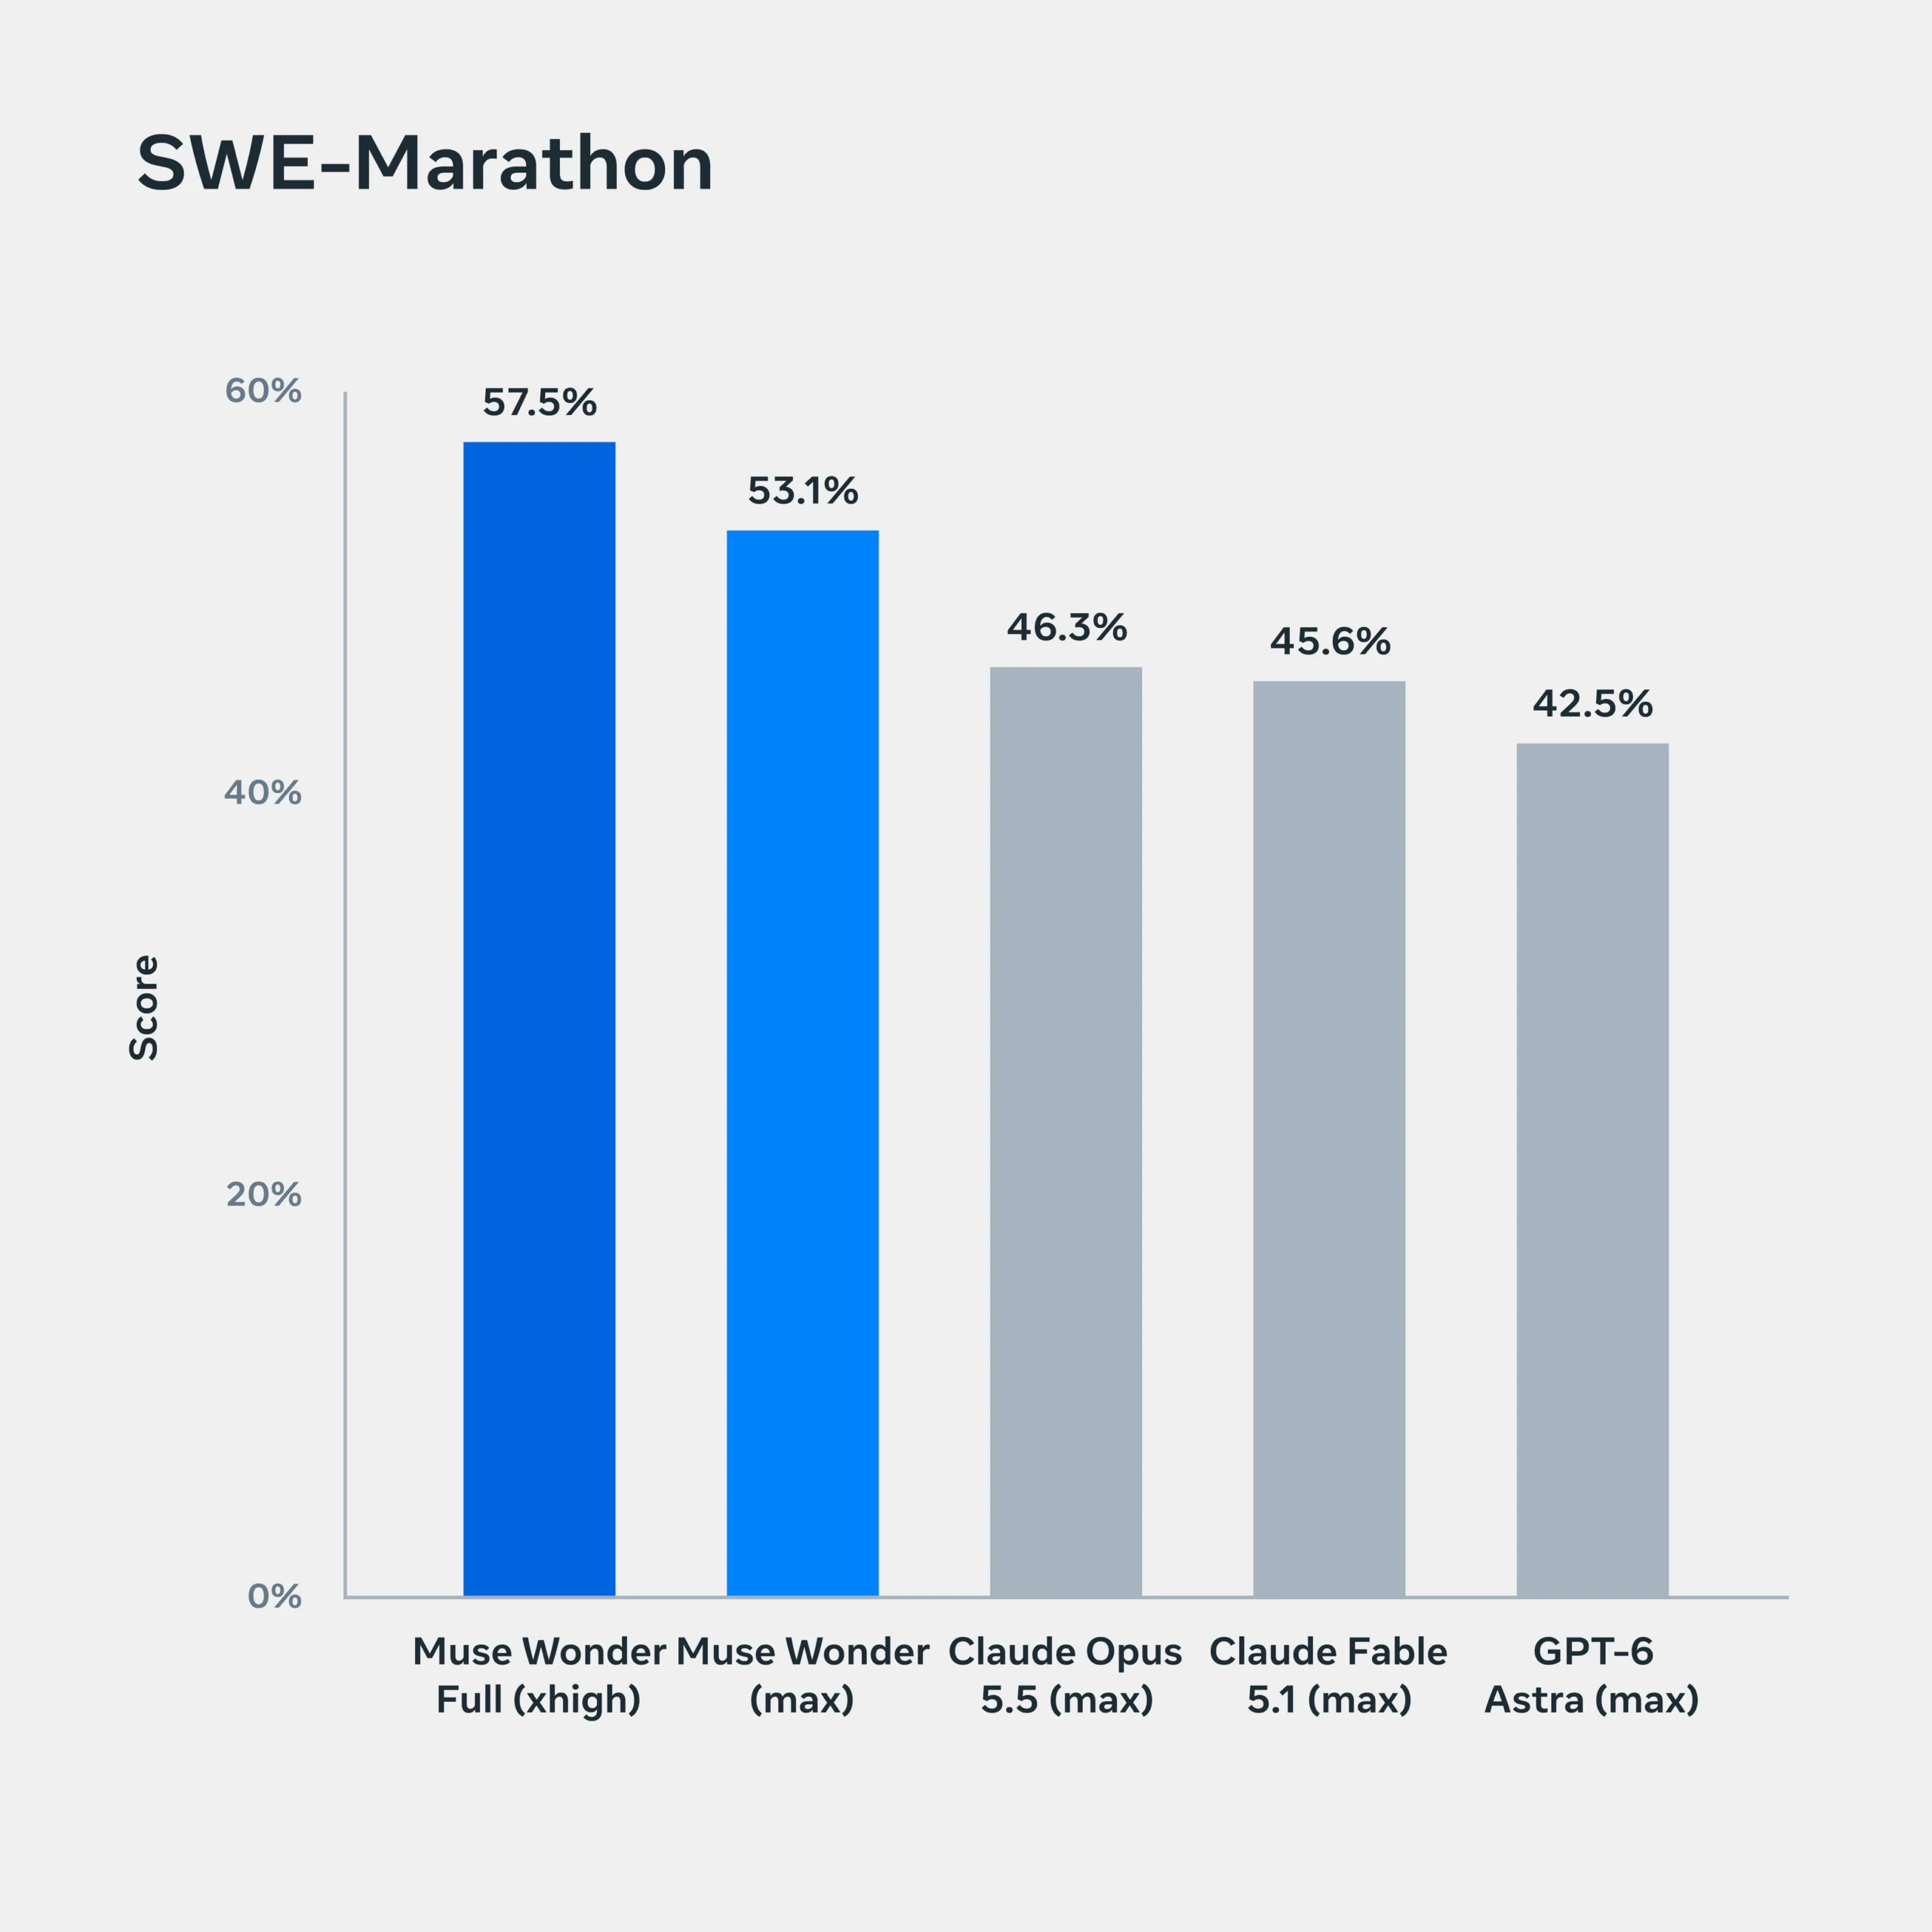
- SWE-Marathon, qui teste des projets logiciels de très longue durée : 57,5 pour Muse Wonder Full (en effort xhigh), contre 46,3 pour Claude Opus 5.5 et 42,5 pour GPT-6 Astra.
- Terminal-Bench 4.0-AA : 57,1 pour Muse Wonder Full, derrière Claude Opus 5.5 (59,6) et GPT-6 Astra (59,1).
- ProgramBench, la programmation à partir de zéro : 59,0 pour Muse Wonder Full, loin derrière Claude Opus 5.5 (70,5).
Dans le billet pour développeurs, Meta affirme que Muse Wonder Full arrive en tête de DeepSWE et de SWE-Marathon lors d’exécutions menées par des tiers indépendants.
Où Muse Wonder reste derrière la concurrence
Le tableau de Meta ne montre pas une domination sur toute la ligne. Claude Opus 5.5 garde l’avantage sur plusieurs tests : HealthBench Pro (65,6 contre 62,3), JobBench (75,4 contre 75,3), OSWorld V2.1 en score partiel (81,8 contre 78,4), Terminal-Bench et surtout ProgramBench. GPT-6 Astra mène sur GDP.pdf, un test de travail professionnel (34,2 contre 33,2).
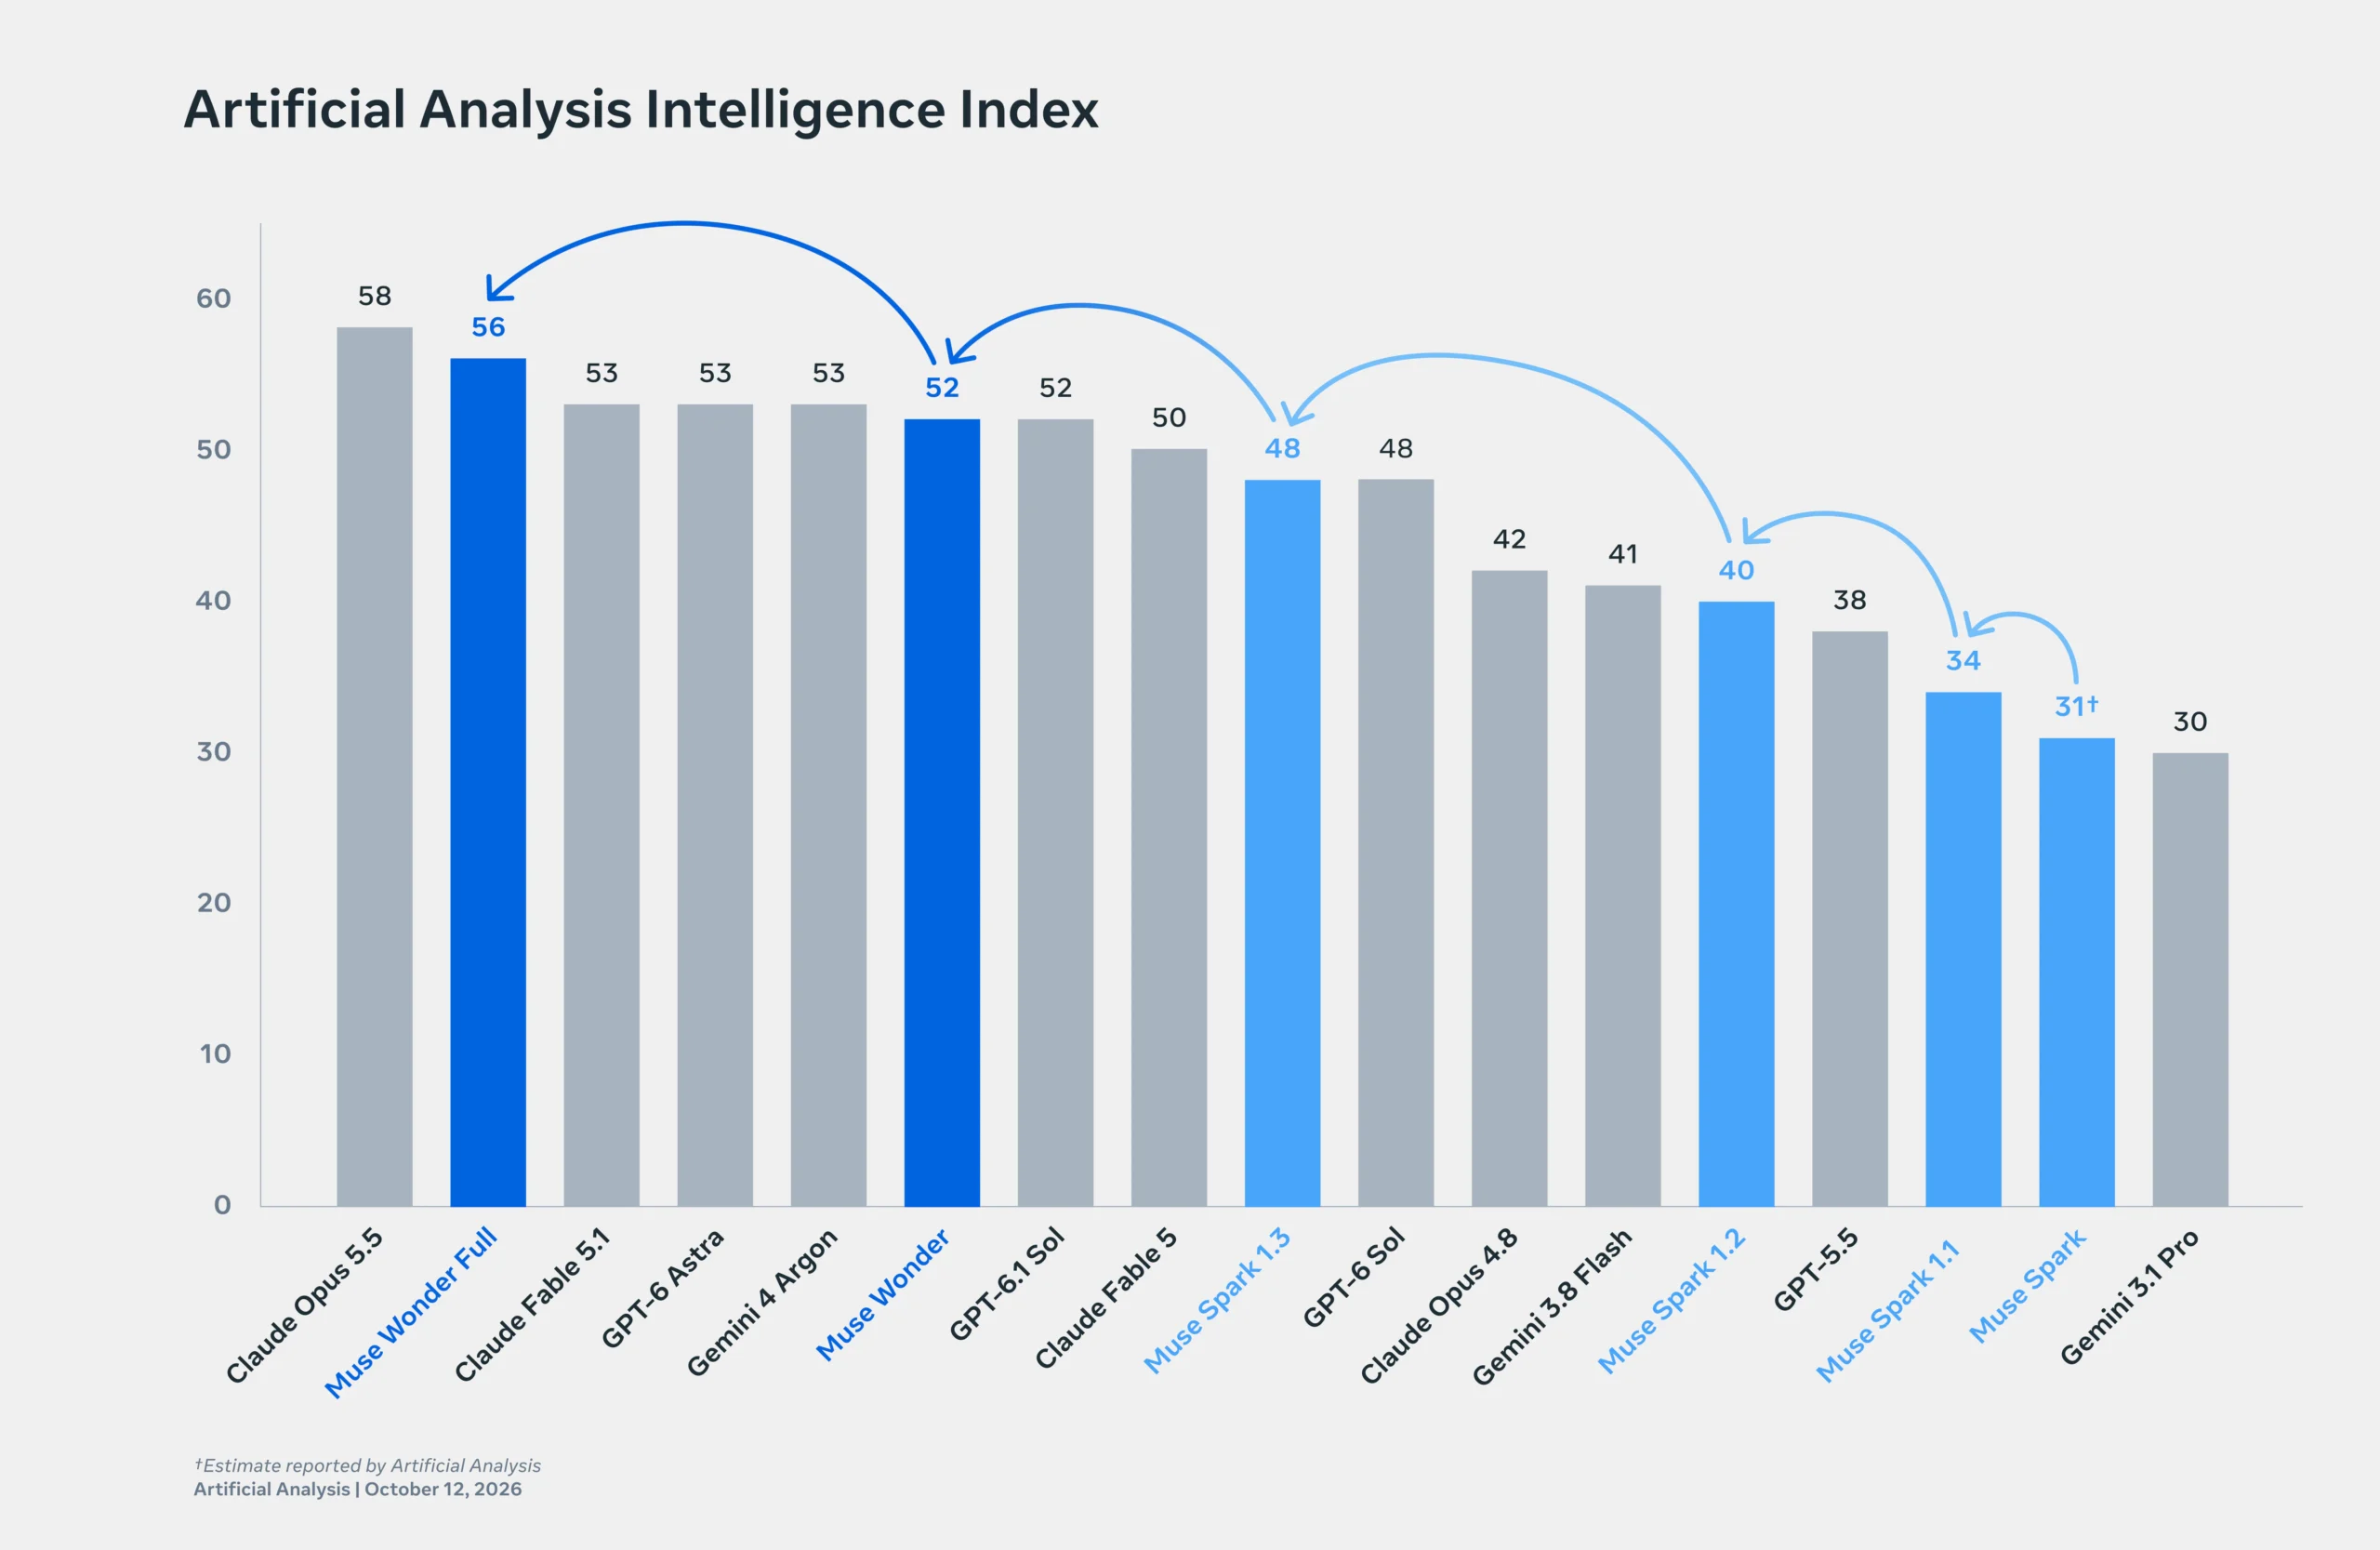
Sur l’indice général d’Artificial Analysis, publié le 12 octobre 2026 et repris par Meta, Claude Opus 5.5 reste premier avec 58. Muse Wonder Full arrive deuxième avec 56, devant Claude Fable 5.1, GPT-6 Astra et Gemini 4 Argon, à 53 chacun. Muse Wonder obtient 52, au niveau de GPT-6.1 Sol. Muse Spark 1.3, le modèle précédent de Meta, était à 48.
Des capacités qui se généralisent
Meta consacre une partie de l’annonce à une critique fréquente des modèles d’IA : de bons scores sur des tests connus, mais des résultats décevants sur des tâches nouvelles. Pour mesurer cet écart, Meta compare Muse Spark 1.3 et Muse Wonder Full sur deux groupes de tâches. Le premier regroupe les tâches ciblées pendant le post-entraînement. Le second rassemble des tâches qui n’ont pas été ciblées.
Selon Meta, les deux modèles progressent de façon similaire sur les tâches inconnues quand on augmente le temps de calcul au moment de répondre. Mais Muse Wonder Full fait mieux sur ces tâches que ce que la tendance de Muse Spark 1.3 laissait prévoir. Meta attribue ce gain à des modèles de base plus grands et plus solides, dont les progrès se transfèrent mieux aux situations nouvelles. Pour un agent personnel, qui rencontre des combinaisons d’objectifs et d’outils impossibles à toutes prévoir, c’est un point important.
Quelles démonstrations Meta a-t-il montrées ?
Le billet officiel présente plusieurs démonstrations :
- un jeu de cuisine en 3D jouable, construit à partir d’images personnalisables ;
- un plan de course à pied pour le samedi, préparé directement dans un navigateur et entre plusieurs applications, selon les préférences et la situation de la personne ;
- des cadeaux personnalisés : Muse Wonder conçoit et commande des objets à partir de vraies photos tirées d’un profil Instagram ;
- un plan de table de mariage, établi à partir d’une liste de contraintes complexes.
Sur X, Alexandr Wang, de Meta, a partagé de nombreux exemples réalisés par des utilisateurs : jeux, animations, design et réalisation vidéo. Il qualifie Muse Wonder de « meilleur modèle au monde pour les agents personnels et professionnels ». Son message a recueilli plus de 3 300 mentions J’aime.
Prix et disponibilité
Muse Wonder (identifiant muse-wonder-1.0) est facturé à l’usage dans le Meta Model API : 4 $ par million de jetons en entrée, 0,20 $ par million de jetons d’entrée mis en cache et 20 $ par million de jetons en sortie. La fenêtre de contexte atteint 1 million de jetons. La documentation indique une limite de 3 000 requêtes et 4 millions de jetons par minute. Le mode Contributor, proposé pour Muse Spark, n’est pas disponible pour Muse Wonder.
Muse Wonder Full n’existe pas dans l’API. Il faut un abonnement à Muse Code, l’agent de code de Meta qui fonctionne dans le terminal. Les forfaits Muse Code sont les suivants :
- Everyday Usage : 5 $ par mois ;
- High Usage : 15 $ par mois ;
- Power Usage : 50 $ par mois, avec accès à Muse Wonder Full ;
- Maximum Usage : 200 $ par mois, un nouveau forfait avec 80 fois la limite d’Everyday Usage et accès à Muse Wonder Full.
Les limites se renouvellent toutes les cinq heures et chaque semaine. Le jour du lancement, Alexandr Wang a signalé sur X un bug qui faisait consommer trop vite les quotas des abonnés Muse Code avec les deux modèles. Il a annoncé quelques heures plus tard que le problème était corrigé et que les compteurs avaient été remis à zéro.
Pour le grand public, Muse Wonder alimentera bientôt l’application Muse, d’abord pour les abonnés. Meta prévoit aussi de l’utiliser pour la génération de contenus et pour créer des modèles spécialisés destinés à tous les utilisateurs de Muse. Aucune date précise n’a été donnée.
Sécurité : ce que Meta annonce
Un agent personnel agit au nom de l’utilisateur et peut accéder à ses messages, son agenda ou ses documents privés. Meta affirme avoir entraîné la famille Muse Wonder pour résister aux instructions malveillantes et traiter avec discrétion les informations privées.
Selon Meta, Muse Wonder offre ses protections les plus solides à ce jour contre les usages abusifs liés aux armes chimiques, biologiques, radiologiques et nucléaires et contre la cybercriminalité. Il conserve l’accès aux capacités de cybersécurité avancées pour un usage défensif, conformément au Meta Superintelligence Scaling Framework. Meta le présente comme son modèle le mieux aligné. Un rapport complet avec des évaluations de sécurité supplémentaires est annoncé, sans date.
Ce que ce lancement change
Avec Muse Wonder, Meta entre directement dans la compétition des modèles de pointe, face à Anthropic, OpenAI et Google. Les chiffres publiés placent Muse Wonder Full au deuxième rang de l’indice d’Artificial Analysis, juste derrière Claude Opus 5.5, et en tête de plusieurs tests d’agents et de code longue durée.
Le prix compte aussi. À 4 $ et 20 $ par million de jetons, Muse Wonder vise les développeurs qui construisent des agents. Le fait de réserver la version Full à Muse Code montre que Meta veut attirer les développeurs vers son propre outil de code. Pour les utilisateurs de Muse, l’arrivée annoncée de Muse Wonder dans l’application s’inscrit dans la stratégie de Meta autour de l’agent personnel, déjà visible avec les gadgets Muse et Home Link.
Pour comparer avec les autres offres, consultez la fiche Meta AI, la fiche Muse, la fiche Muse Code, le guide pour choisir entre GPT-6 Astra, Sol et Luna, l’article sur Gemini 4 Argon et la fiche Claude.
Questions
Quelle est la différence entre Muse Wonder et Muse Wonder Full ?
Muse Wonder Full est le modèle le plus avancé, avec les meilleurs scores, et il est réservé aux abonnés Muse Code Power Usage et Maximum Usage. Muse Wonder est disponible dans l’API et dans Muse Code, avec des performances que Meta juge comparables.
Combien coûte Muse Wonder ?
Dans le Meta Model API, 4 $ par million de jetons en entrée, 0,20 $ en entrée mise en cache et 20 $ en sortie. Muse Wonder Full est inclus dans les forfaits Muse Code à 50 $ et 200 $ par mois.
Muse Wonder est-il disponible dans l’application Muse ?
Pas encore. Meta indique qu’il alimentera bientôt Muse, d’abord pour les abonnés, sans date précise.
Muse Wonder est-il le meilleur modèle du moment ?
Pas sur tous les tests. Meta le place en tête de plusieurs benchmarks d’agents et de code longue durée, mais Claude Opus 5.5 reste premier sur l’indice d’Artificial Analysis (58 contre 56) et sur plusieurs tests de code.
Quelle taille de contexte gère Muse Wonder ?
1 million de jetons, pour Muse Wonder comme pour Muse Wonder Full.
Les modèles sont-ils ouverts ?
Meta ne mentionne pas de publication des poids. Les deux modèles sont accessibles uniquement via le Meta Model API et Muse Code.