Astra pour le raisonnement le plus difficile, GPT-6.1 Sol pour le code, la recherche et l’ordinateur, Luna pour les tâches ciblées répétées.
Choisir entre GPT-6 Astra, GPT-6.1 Sol et Luna
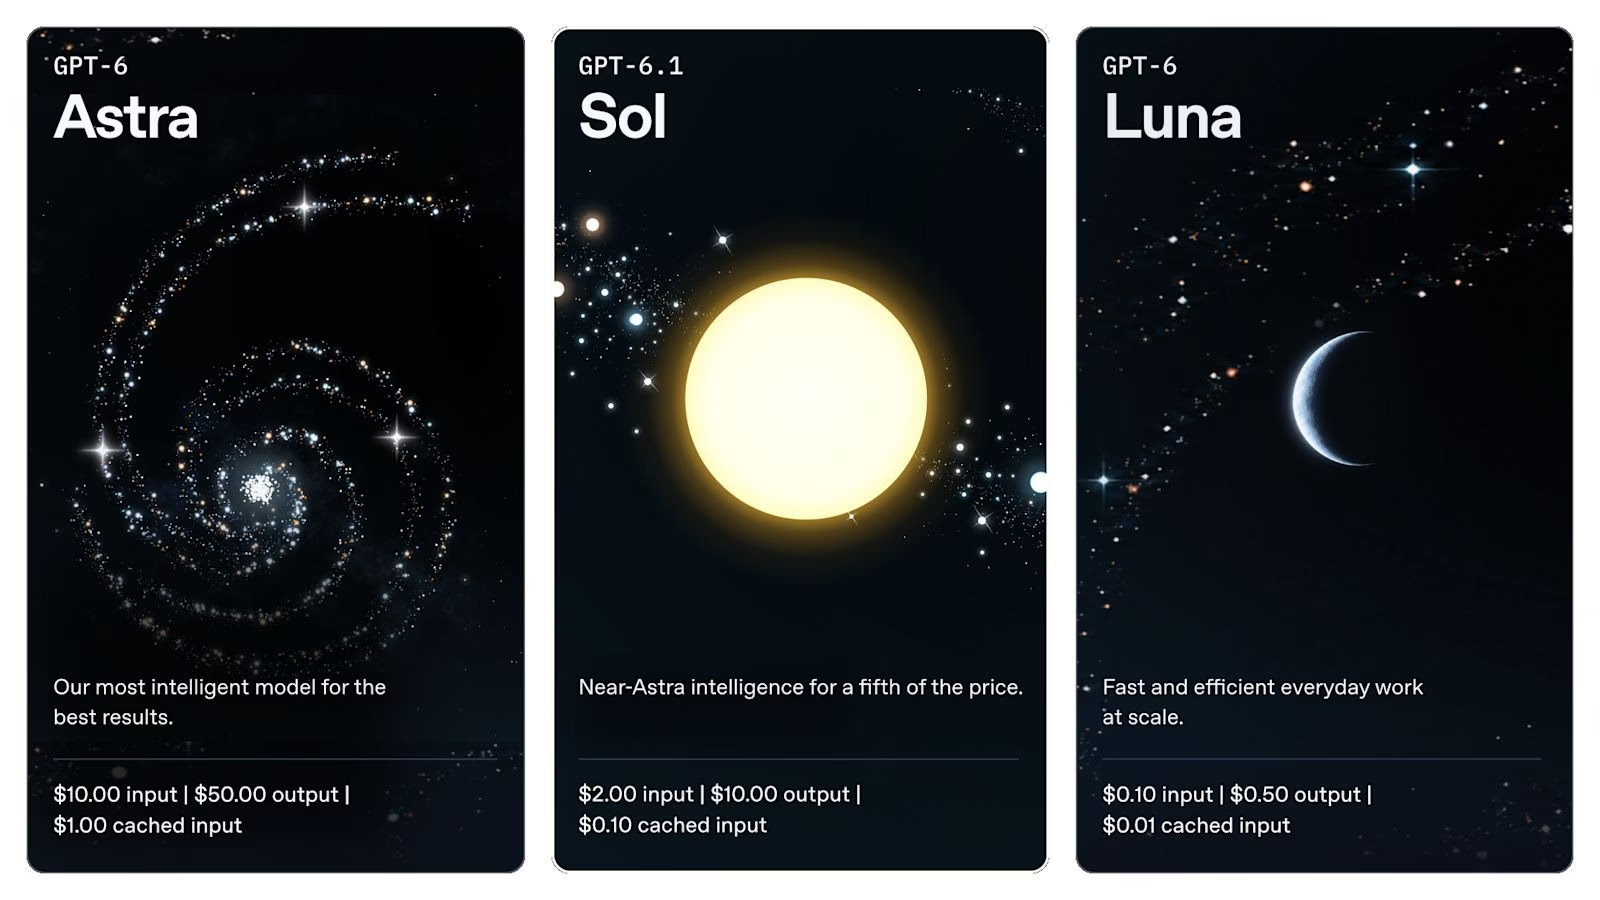
GPT-6 Astra prend le raisonnement le plus difficile, GPT-6.1 Sol prend le code complexe, la recherche et l'usage d'un ordinateur, et GPT-6 Luna prend les tâches ciblées que vous répétez avec un objectif clair, comme extraire les champs d'une facture, classer une demande ou produire un résumé structuré.
Le choix se joue entre l'intelligence, le prix et la latence. Vous réglez ensuite l'effort de raisonnement et la vitesse, puis vous préparez le cache, le contexte et le contrôle du travail long avant de passer en production. Les faits viennent du guide pratique OpenAI pour construire avec GPT-6.
Choisissez Astra si la tâche demande l'intelligence maximale et que le temps ou le coût supplémentaire se justifie. Choisissez GPT-6.1 Sol si le cœur du travail est le code complexe, la recherche ou l'usage d'un ordinateur, y compris des sous-tâches indépendantes. Choisissez Luna si vous lancez souvent la même tâche bornée, à grande échelle, et que le résultat attendu est déjà clair.
Le choix en un coup d'œil
| Modèle | Rôle | Entrée | Sortie | Entrée en cache |
|---|---|---|---|---|
| GPT-6 Astra | Raisonnement le plus difficile. Le modèle le plus intelligent, pour les meilleurs résultats. Ultrafast est disponible. | $10.00 | $50.00 | $1.00 |
| GPT-6.1 Sol | Code complexe, recherche et usage d'un ordinateur. Intelligence proche d'Astra pour un cinquième du prix. Multi-agent en bêta. | $2.00 | $10.00 | $0.10 |
| GPT-6 Luna | Tâches ciblées à grande échelle et travail répété à objectif clair. Travail quotidien rapide et efficace, à l'échelle. | $0.10 | $0.50 | $0.01 |
Ces trois lignes sont un arbitrage entre intelligence et prix. Les montants ci-dessus sont ceux imprimés pour l'entrée, la sortie et l'entrée en cache. Les tarifs sont dans la comparaison des prix des modèles. Les fiches sont celles de GPT-6 Astra, de GPT-6.1 Sol et de GPT-6 Luna.
Quand prendre Astra
Astra est le modèle du raisonnement le plus difficile, là où l'intelligence maximale est nécessaire. C'est le modèle le plus intelligent, pour les meilleurs résultats. L'entrée imprimée est de $10.00, la sortie de $50.00, l'entrée en cache de $1.00. Pour l'effort, testez Extra high ou Max là où ce niveau existe, et gardez-le seulement si le gain justifie le temps et le coût en plus. Ce réglage n'est pas une note de modèle.
Dans Codex, Astra peut poser une question de clarification pendant qu'il travaille. Répondez à ce qui bloque l'étape suivante, et dites quel travail indépendant peut continuer pendant que vous décidez. Si vous vous absentez, indiquez quelles tâches continuent et à quel moment il doit s'arrêter pour attendre votre réponse.
Ultrafast est disponible pour Astra, dans Codex et dans l'API. Il accélère la génération des jetons, indépendamment de l'effort de raisonnement. Il sert quand une réponse plus rapide vaut le supplément, par exemple des itérations de code rapides. Le mode Ultrafast ne remplace pas le choix du niveau de raisonnement. Vous pouvez vouloir une réponse plus rapide sans pour autant monter l'effort au maximum.
Astra utilise aussi l'ordinateur : sites et applications de bureau, même sans API. Vous demandez d'examiner un bug, de corriger le code, puis d'ouvrir le produit dans un navigateur pour vérifier que la correction tient. Ce n'est pas une raison de prendre Astra pour une extraction de facture. Pour ce travail-là, Luna suffit.
Quand prendre GPT-6.1 Sol
GPT-6.1 Sol est le modèle du code complexe, de la recherche et de l'usage d'un ordinateur. Prenez-le quand la tâche a plusieurs parties indépendantes, par exemple inspecter des zones différentes d'une base de code, puis réunir les constats dans une seule réponse.
Dans l'API Responses, Sol peut confier ces sous-tâches à des sous-agents. Le multi-agent est actuellement en bêta. Bornez ce que chaque sous-agent peut faire, et ne lui donnez pas une décision que vous devez garder. Le détail est dans le guide du multi-agent. Sol apporte une intelligence proche d'Astra pour un cinquième du prix. L'entrée imprimée est de $2.00, la sortie de $10.00, l'entrée en cache de $0.10.
Sol utilise l'ordinateur, comme Astra et comme Luna. La règle de choix reste la même. S'il existe une API ou un outil connecté qui fait l'étape directement, utilisez cet outil. Réservez l'usage d'un écran au moment où le modèle doit lire une page, cliquer un bouton ou remplir un formulaire.
Le mode Fast de l'API s'applique quand le délai de réponse compte, dans un chat ou un outil de code. Il donne des réponses plus rapides et plus stables, à un coût par jeton plus élevé que le traitement Standard. Ultrafast est disponible pour GPT-6 Astra.
Quand prendre Luna
GPT-6 Luna est le modèle des tâches ciblées à grande échelle et du travail quotidien répété, quand l'objectif est déjà clair. Luna vise le travail quotidien, rapide et efficace, à grande échelle. L'entrée imprimée est de $0.10, la sortie de $0.50, l'entrée en cache de $0.01. Les exemples sont l'extraction des champs d'une facture, le classement des demandes et le résumé structuré.
Pour ce type de tâche, le niveau de raisonnement Low correspond au travail de routine : extraire des faits ou faire de petites modifications. Monter à High ou à Extra high ajoute du temps et du coût. Mesurez le succès de la tâche, la latence et le coût par tâche réussie avant de changer de modèle ou de niveau.
Luna utilise aussi l'ordinateur. Cela ne le transforme pas en modèle du raisonnement le plus dur. Si l'étape consiste à ouvrir une facture dans un site qui n'a pas d'API, à lire l'écran et à recopier les champs, l'usage d'un ordinateur est adapté. Si l'étape est un débogage difficile ou une analyse que High ne tient pas, revenez à Astra.
Le mode Fast reste utile si ces tâches répétées sont dans un chat ou un outil où le délai compte. Le coût par jeton est plus élevé qu'en traitement Standard. La fiche est celle de GPT-6 Luna.
Régler le niveau de raisonnement
Dans l'API, le niveau de raisonnement est l'effort que le modèle consacre à la tâche. Le détail de ce réglage est dans le guide du raisonnement.
Low convient aux tâches de routine, comme extraire des faits ou faire de petites modifications. Medium convient au travail qui demande du jugement, comme planifier une fonctionnalité ou comparer des options. High convient au débogage difficile, à l'analyse plus profonde ou à la relecture soigneuse. Extra high, aussi appelé Max, se teste là où il est pris en charge, et seulement quand High ne suffit pas. Vous ne le gardez que si l'amélioration justifie le temps et le coût ajoutés.
Dans Codex, partez du niveau de raisonnement par défaut de ce modèle. Baissez-le pour une tâche plus simple. Montez-le pour une analyse plus profonde. Ne commencez pas par le maximum sur un résumé structuré ou sur un classement de demandes.
Le niveau et le modèle ne sont pas le même levier. Vous pouvez garder Luna et monter de Low à Medium si le classement demande du jugement. Vous pouvez garder Astra et baisser l'effort si la tâche est devenue une petite modification. L'ensemble reste un arbitrage entre intelligence et prix, pas un classement par note.
Choisir la vitesse
Deux réglages de vitesse sont distincts du niveau de raisonnement.
Dans l'API, le mode Fast sert quand le délai de réponse compte, par exemple une application de chat ou un outil de code. Il fournit des délais plus rapides et plus réguliers, à un coût par jeton plus élevé que le traitement Standard. Prenez-le pour l'attente de l'utilisateur, pas pour rendre une tâche plus intelligente.
Dans Codex et dans l'API, Ultrafast sert quand une réponse plus rapide vaut le supplément, par exemple des itérations de code rapides. Il accélère la génération des jetons sans changer l'effort de raisonnement. Ultrafast est disponible pour GPT-6 Astra.
Vous pouvez donc combiner les leviers sans les confondre. Un chat qui classe des demandes peut rester sur Luna, en Low, avec le mode Fast si l'attente est le problème. Une itération de code très rapide sur un problème dur peut passer sur Astra avec Ultrafast, puis redescendre l'effort si la tâche se simplifie. Le coût par jeton monte avec Fast par rapport à Standard, et Ultrafast est un supplément. Le cache, lui, joue sur l'entrée déjà vue, pas sur ces modes.
Préparer la production
Avant de déployer, plusieurs contrôles comptent. Ils ne changent pas le modèle. Ils changent ce que vous envoyez, ce que vous mesurez et ce que vous gardez.
Coupez le contexte dont la tâche n'a pas besoin, et gardez la preuve dont elle a besoin. Le détail est dans coût et latence. Quand l'application le permet, lancez ensemble les tâches indépendantes, pour qu'une étape lente ne bloque pas un travail sans lien. Voir parallélisation.
Réutilisez le contexte partagé avec le cache d'invite pour le travail qui revient. Les jetons d'entrée en cache coûtent jusqu'à 95 % de moins que les jetons d'entrée non mis en cache, selon le modèle. Placez les instructions stables et les documents de référence avant le détail qui change à chaque tâche, et gardez les définitions d'outils stables. Le tableau de bord du cache et le guide de diagnostic du cache montrent où cette réutilisation casse. Dans l'estimation du coût d'un flux complet, comptez les écritures de cache et les tarifs de long contexte éventuels. Le « jusqu'à 95 % » n'est pas une remise garantie sur chaque appel.
Pour une conversation plus longue, la compaction réduit la taille du contexte tout en gardant l'état nécessaire pour continuer. Décidez aussi comment vous surveillez le comportement et relisez les contrôles de données de votre application.
Testez avant de déployer. Lancez des tâches représentatives et mesurez le succès de la tâche, la latence et le coût par tâche réussie. La liste de déploiement de l'API inclut le choix du modèle pour la charge. Un flux qui réussit une fois sur un exemple facile ne suffit pas. Le coût qui compte est celui de la tâche réussie, pas le prix d'un jeton isolé.
Donner une consigne qui tient
La consigne de départ dit le résultat voulu, pour qui il est, le contexte utile, les contraintes, et ce qui compte comme terminé. Quatre zones suivent, à partir du texte sur les compétences et les invites pour GPT-6 Astra.
Les compétences doivent avoir une description courte, et dire explicitement quand chacune doit s'exécuter. Chargez le détail d'appui seulement quand il sert. Remplacez une recette rigide par une guidance adaptée aux modèles que votre équipe utilise vraiment.
Le fichier AGENTS.md doit dire quand tel document ou tel test est pertinent. Il doit autoriser explicitement les flux de routine sûrs, par exemple lancer des tests locaux avec des données jetables, sans accès à la production.
Les limites de décision remplacent une règle du type « demande toujours ». Vous écrivez quelles actions avancent seules et lesquelles exigent un accord. Le modèle peut choisir comment organiser un résumé. Il doit vous consulter avant de changer le périmètre du projet. Voir initiative et suivi.
La persistance dit ce que « terminé » contient. Ici, cela veut dire implémenter le changement, le lancer, inspecter le résultat et corriger les échecs. Vous identifiez aussi les décisions qui restent à votre relecture.
Pour la forme de la réponse, demandez un langage clair, un niveau de détail technique adapté au lecteur, et un court passage de passation. Ce passage couvre ce qui a changé, ce qui a été vérifié et ce qui demande encore attention. Voir personnalité et style d'écriture.
Voici la seule suite d'étapes à suivre pour une consigne, que vous soyez dans Codex ou dans l'API.
- Écrivez le résultat, le destinataire, le contexte, les contraintes et la définition de terminé, y compris lancer le changement, l'inspecter et corriger les échecs.
- Écrivez les décisions que le modèle prend seul et celles qui exigent votre accord, par exemple organiser un résumé seul, mais demander avant de changer le périmètre.
- Demandez une passation courte : ce qui a changé, ce qui a été vérifié, et ce qui reste à regarder.
Tenir un travail long
Avec cette famille de modèles, une tâche peut durer des heures ou des jours. Trois mécanismes de l'API servent à la garder sur les rails. Aucun n'annule le besoin d'une consigne claire.
La direction en cours de tour permet d'envoyer une correction pendant que le modèle travaille, via l'API WebSocket des réponses. Les mises à jour sont mises en file. Elles n'annulent pas un outil déjà en cours et elles ne défont pas une action déjà terminée. Si une étape est déjà faite, votre correction vaut pour la suite, pas pour le passé.
L'appel d'outil asynchrone laisse le modèle continuer un travail indépendant pendant que votre application exécute une tâche plus lente, comme des tests. L'application renvoie le résultat quand il est prêt. Attendez ce résultat avant de lancer un travail qui en dépend. Continuer autre chose n'autorise pas à deviner le résultat du test.
La délégation est le multi-agent de GPT-6.1 Sol, en bêta. Sol peut assigner un travail indépendant, par exemple des parties différentes d'une base de code, puis combiner les constats. Ne déléguez pas une étape qui dépend du résultat d'une autre.
Dans Codex, deux gestes complètent cela. Avec Astra, répondez aux questions qui bloquent l'étape suivante et laissez continuer le travail indépendant. Quand le besoin change, redirigez la tâche active avec l'information nouvelle. Dites ce qui doit changer et ce qui doit rester. Cela évite de continuer une approche qui ne correspond plus au besoin.
Usage d'un ordinateur
L'usage d'un ordinateur permet à Astra, à GPT-6.1 Sol et à Luna d'agir sur des sites et des applications de bureau, y compris une application sans API. Par exemple, examiner un bug, corriger le code, ouvrir le produit dans un navigateur et vérifier que la correction tient.
Choisissez le moyen le plus simple qui reste fiable. Une API ou un outil connecté d'abord, quand il fait l'étape directement. L'écran ensuite, quand il faut lire, cliquer ou remplir un formulaire.
Si vous intégrez cela dans votre propre application, donnez au modèle un outil capable d'exécuter du code pour contrôler un navigateur ou un bureau. Playwright fonctionne avec les navigateurs. PyAutoGUI fonctionne avec les applications de bureau. Voir les exemples de harnais.
Lire un écran pour vérifier une correction est un contrôle. Changer le périmètre du projet reste une décision à vous soumettre.
Ce que des équipes font avec Astra
Ces exemples portent sur Astra, pas sur un classement des trois modèles. Ils viennent du même guide pratique.
Harvey réunit des informations de tribunal, de la jurisprudence, des documents du cabinet et les préférences d'un avocat pour adapter ses brouillons. Donner plus de contexte au modèle permet des sorties mieux structurées.
Cognition utilise Astra dans Devin pour tester un logiciel et renvoyer des preuves. Dans un exemple de jeu pour iPhone, Devin a produit un enregistrement du simulateur et un rapport qui sépare les contrôles réussis des zones non testées, pour rendre le travail restant plus visible.
Hex utilise Astra pour transformer des questions sur la performance des canaux de vente en constats écrits et en tableaux de bord interactifs, y compris des découpages géographiques. Le modèle doit aussi examiner si les chiffres tiennent et si l'analyse répond à la question.
Invideo utilise Astra pour planifier des modifications de timeline et créer des effets que les monteurs peuvent ensuite affiner. Invideo rapporte un taux de succès environ trois fois plus élevé sur les tâches d'étalonnage et de correction, et quelques monteurs ont aussi créé environ 50 effets en une journée. Ce chiffre est celui rapporté par Invideo, pas une note du modèle.
Ce qu'il ne faut pas conclure
Le cadre reste celui du guide pratique OpenAI pour construire avec GPT-6. Il n'y a pas de note, de classement chiffré ni de disponibilité par pays dans ces faits. Un niveau de raisonnement plus haut ne garantit pas une tâche réussie. Mesurez le succès de la tâche, la latence et le coût par tâche réussie.
Ultrafast est disponible pour Astra. Le multi-agent est celui de GPT-6.1 Sol, et il est en bêta.
Le cache peut faire baisser fortement le coût de l'entrée déjà vue, jusqu'à 95 % de moins selon le modèle. Ce n'est pas une baisse automatique du coût de sortie, ni une baisse du mode Fast. Pour estimer un flux, ajoutez les écritures de cache et les tarifs de long contexte s'il y en a.
GPT-6 est la suite de modèles la plus avancée, avec un choix selon le type de travail. Le périmètre va de l'idée au prototype, de la construction au test d'une fonctionnalité, et à l'orchestration de flux en plusieurs étapes à travers des dépôts de code, des bases de données et des API externes. Le modèle ne remplace pas la consigne, la limite de décision ni la mesure avant déploiement.
Questions
Les trois modèles peuvent-ils utiliser un ordinateur ?
Oui. Astra, GPT-6.1 Sol et GPT-6 Luna peuvent agir sur des sites et des applications de bureau, y compris une application sans API. Vous gardez quand même l'API ou l'outil connecté quand il fait l'étape directement.
Le multi-agent est-il disponible sur Astra et sur Luna ?
Le multi-agent de GPT-6.1 Sol, dans l'API Responses, est en bêta. Avec GPT-6 Astra dans Codex, le modèle peut demander une clarification pendant qu'il travaille.
Ultrafast marche-t-il pour Sol et pour Luna ?
Ultrafast est disponible pour GPT-6 Astra, dans Codex et dans l'API. Le mode Fast de l'API vaut quand le délai compte, comme un chat ou un outil de code, sans être réservé à un seul des trois noms.
Faut-il toujours le niveau le plus haut ?
Non. Low pour la routine, Medium pour le jugement, High pour le débogage difficile, l'analyse profonde ou la relecture soigneuse. Extra high ou Max se teste seulement là où il est pris en charge, quand High ne suffit pas, et se garde seulement si le gain paie le temps et le coût. Dans Codex, partez du défaut du modèle, puis baissez ou montez.
Le cache baisse-t-il toujours le prix de 95 % ?
Non. Les jetons d'entrée en cache coûtent jusqu'à 95 % de moins que l'entrée non mise en cache, selon le modèle. Placez le stable avant le variable et gardez les outils stables. Comptez aussi les écritures de cache et les tarifs de long contexte dans le coût du flux complet.
Une correction en cours de route annule-t-elle le travail déjà fait ?
Non. Une mise à jour envoyée pendant le tour est mise en file. Elle n'annule pas un outil en cours et elle ne défait pas une action terminée. Pour un outil lent, comme une suite de tests, attendez le résultat avant de lancer ce qui en dépend.